هوش مصنوعی در تشخیص گفتار و تولید گفتار؛ انقلابی در تعامل انسان و ماشین
در دههی اخیر، هوش مصنوعی به شکل چشمگیری نحوهی تعامل ما با دستگاهها را تغییر داده است. یکی از مهمترین این پیشرفتها، تشخیص گفتار (Speech Recognition) و تولید گفتار (Text-to-Speech) است. امروزه فناوریهایی مانند تشخیص صدا با هوش مصنوعی، تبدیل نوشتار به گفتار گوگل و حتی تشخیص صدا با پایتون در بسیاری از ابزارها و اپلیکیشنها اجرا شدهاند. این فناوریها به ما امکان میدهند بدون لمس گوشی، بدون تایپ و تنها با صحبت کردن با دستگاهها ارتباط برقرار کنیم.
فناوری تشخیص گفتار نخستین بار در دهه ۱۹۵۰ مطرح شد؛ زمانی که سیستمها تنها قادر بودند چند عدد یا واژه ساده را شناسایی کنند. اما با گسترش علوم کامپیوتر، یادگیری ماشین و ظهور شبکههای عصبی پیشرفته، این فناوری به مرحلهای رسیده است که میتواند گفتار طبیعی، طولانی و پیچیده را با دقت چشمگیر پردازش و تشخیص دهد.
هوش مصنوعی در تشخیص گفتار و تولید گفتار چیست؟
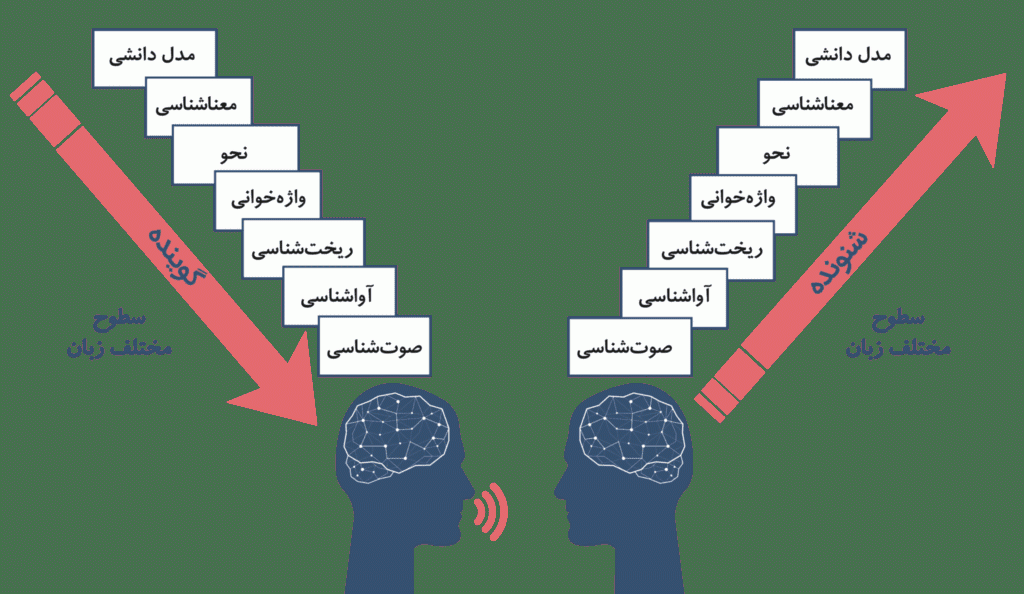
هوش مصنوعی در تشخیص گفتار مجموعهای از مدلهای یادگیری عمیق است که صدای انسان را دریافت کرده، آن را تحلیل کرده و در نهایت به متن تبدیل میکند. برعکس این روند، در تولید گفتار متن ورودی به صدا تبدیل میشود.
این سیستمها شامل چند مرحله هستند:
- پردازش صوت در هوش مصنوعی
- استخراج ویژگیهای صوتی (MFCC, MelSpectrogram)
- مدلسازی با شبکههای عصبی (RNN, Transformer)
- تبدیل خروجی به متن یا گفتار
ترکیب و تشخیص گفتار از گوگل چیست؟
گوگل یکی از قدرتمندترین ارائهدهندگان خدمات Speech-to-Text (تبدیل گفتار به متن) و Text-to-Speech (تبدیل متن به گفتار) در جهان است.
سرویسهای اصلی گوگل:
- Google Speech Recognition API
برای تبدیل صدا به متن
- Google Text-to-Speech (TTS)
برای تولید صدای طبیعی از متن
این سرویسها در گوشیها، مرورگرها، اسپیکرهای هوشمند و اپلیکیشنهای موبایل استفاده میشوند.
ترکیب و تشخیص گفتار از گوگل در گوشیهای شیائومی
شیائومی از سرویسهای گوگل و مدلهای اختصاصی خود برای پردازش گفتار استفاده میکند. در گوشیهای شیائومی:
- دستیار صوتی
- Google Assistant
- تایپ صوتی در Gboard
- تبدیل گفتار به متن در پیامرسانها
همگی از ترکیب و تشخیص گفتار از گوگل شیائومی بهره میبرند.
تشخیص صدا با هوش مصنوعی
تشخیص صدا با AI شامل:
- شناسایی واژهها
- تشخیص گوینده
- تحلیل احساسات صوتی
- تشخیص دستورات صوتی
این تکنولوژی در موارد خانه هوشمند ، رباتها ، خودروهای هوشمند ، اپلیکیشنهای آموزشی و امنیت و احراز هویت صوتی استفاده میشود.
چگونه Speech Recognition را غیر فعال کنیم؟
گاهی کاربران نمیخواهند دستگاه دائماً گوش دهد. برای غیرفعال کردن Speech Recognition میتوان:
در اندروید:
- وارد Settings شوید
- بخش Google → Settings for Google Apps
- Google Assistant را باز کنید
- Voice Match را غیر فعال کنید
در ویندوز:
- Settings
- Privacy → Speech
- Online Speech Recognition را خاموش کنید
پردازش صوت در هوش مصنوعی
پردازش صوت مجموعهای از تکنیکهاست که صدا را به دادههای قابل تحلیل تبدیل میکند. این مرحله شامل:
- پاکسازی نویز
- نرمالسازی صدای ورودی
- استخراج ویژگیها
- مدلسازی با شبکههای عصبی
این بخش اساس تمام سیستمهای گفتاری است.
تبدیل نوشتار به گفتار گوگل (Google TTS)
این فناوری متن کاربران را به صدای طبیعی تبدیل میکند. Google TTS قابلیت:
- تولید صدای انسانی
- پشتیبانی از دهها زبان
- تنظیم سرعت، جنسیت و لحن
کاربردها: کتاب صوتی ، رباتهای گفتگو ، دستیارهای هوشمند و اپلیکیشنهای آموزشی .
تبدیل گفتار به متن در پایتون؛ ساده و کاربردی
پایتون یکی از محبوبترین زبانها برای کار با صدا و هوش مصنوعی است و همچنین رایجترین کتابخانهها:
- SpeechRecognition
- pydub
- vosk
- whisper (مدلهای متنباز OpenAI)
نمونهکار:
با چند خط کد میتوان تشخیص صدا با پایتون و تبدیل گفتار به متن را انجام داد.
ارتباط این حوزه با بازیهای کامپیوتری
هرچند این مقاله درباره هوش مصنوعی در تشخیص گفتار است، اما این فناوری در گیمینگ نیز کاربرد دارد:
- کنترل صوتی شخصیتها
- فرمانهای صوتی در بازیهای VR
- ارتباط زنده با NPCها
- تشخیص احساسات بازیکن
به همین دلیل بسیاری از محتواها به «مقاله درباره هوش مصنوعی در بازیهای کامپیوتری» میپردازند تا نقش پردازش صوت و تعامل صوتی را در گیمینگ بررسی کنند.
در آخر
هوش مصنوعی در تشخیص گفتار و تولید گفتار، یکی از مهمترین دستاوردهای فناوری مدرن است. از ترکیب و تشخیص گفتار از گوگل گرفته تا تبدیل گفتار به متن در پایتون، همه ابزارهایی هستند که ارتباط انسان و ماشین را آسانتر کردهاند. با توسعه مدلهای یادگیری عمیق، آیندهٔ گفتارمحور بسیار هوشمندتر، دقیقتر و کاربردیتر خواهد بود.