مدل های زبانی بزرگ (Large Language Model) چیست و چگونه کار میکند؟
هوش مصنوعی مولد (AI) به سرعت پیشرفت کرده است و هوش مصنوعی را از طریق مدل هایی مانند سری شبکه مبدل از پیش آموزش دیده مولد (GPT) متحول کرده است . این مدل ها با شبکه های عصبی بزرگ، الگوریتم های جدید یادگیری ماشین (ML) و مجموعه داده های آموزشی گسترده، در درک و تولید متن شبیه انسان برتری دارند. دسترسی و چارچوبهای متنباز، دسترسی و استفاده از مدلهای مولد زبان بزرگ (LLM) را برای همگان آسان و فراگیر کردهاند و ادغام آنها را در بخش هایی مانند چت بات ها، مراقبت های بهداشتی و مالی امکان پذیر می کند . این بررسی تجزیه و تحلیل جامعی از LLM ها ارائه می دهد و اصول اساسی، کاربردها، روش ها و چالش های آنها را بررسی می کند. با ارزیابی روش های موجود، شناسایی شکاف های پژوهشی و پیشنهاد مسیرهای آینده، هدف آن ارائه بینش های منسجم ارزشمند به محققان و متخصصان است.
مدلهای زبانی بزرگ چیست؟
مدلهای زبان بزرگ یا LLMها، مدلهای یادگیری عمیق بسیار پیچیدهای هستند که با حجم عظیمی از دادههای متنی آموزش دیدهاند. این مدلها معماری اصلیشان مبتنی بر مبدلها (Transformers) است که قابلیت پردازش همزمان کل توالیهای متنی را دارند، برخلاف شبکههای عصبی بازگشتی (RNN) که دادهها را به صورت ترتیبی پردازش میکردند.
LLMها از میلیاردها پارامتر تشکیل شدهاند؛ این پارامترها به مدل کمک میکنند تا الگوهای پیچیده زبان را درک کند، روابط معنایی میان کلمات را بیاموزد و متنی انسانیمانند تولید کند. به طور مثال، GPT-3 از شرکت OpenAI دارای ۱۷۵ میلیارد پارامتر است که نشاندهنده میزان گستردگی و پیچیدگی این مدلهاست.
LLMها نشاندهندهی یک پیشرفت قابل توجه در NLP و هوش مصنوعی (AI)هستند و از طریق رابطهایی مانند GPT-3 و GPT-4 از Open AI که پشتیبانی مایکروسافت را به دست آوردهاند، به راحتی در دسترس عموم قرار دارند. نمونههای دیگر شامل مدلهای Llama از Meta و نمایشهای رمزگذار دو طرفه گوگل از ترنسفورمرها (BERT/RoBERTa) و مدلهای PaLM است . همچنین اخیرا سری مدل های Granite خود را در watsonx.ai راهاندازی کرده است که به ستون فقرات هوش مصنوعی مولد برای سایر محصولات IBM مانند watsonx Assistant و watsonx Orchestrate تبدیل شده است.
نحوه کار مدلهای زبانی بزرگ (Large Language Model)
مدلهای زبانی بزرگ (LLM) با استفاده از تکنیکهای یادگیری عمیق و پردازش حجم عظیمی از دادههای متنی آموزش داده میشوند. این مدلها معمولاً بر پایه معماری مبدل (Transformer) ساخته شدهاند که شامل چندین لایه شبکه عصبی با پارامترهای فراوان است. این پارامترها در طی فرآیند آموزش بهصورت دقیق تنظیم میشوند تا مدل بتواند الگوهای پیچیده زبان را درک کند. یکی از اجزای کلیدی این معماری، مکانیسم توجه (Attention) است که به مدل اجازه میدهد روی بخشهای خاصی از دادهها متمرکز شود و روابط میان کلمات و جملات را بهتر درک کند.
در طول فرآیند آموزش، مدلهای زبانی بزرگ یاد میگیرند که کلمه بعدی در یک جمله را بر اساس زمینهی ارائه شده توسط کلمات قبلی پیشبینی کنند. برای این منظور، متن ورودی ابتدا به توکنهایی تقسیم میشود که به بخشهای کوچکتر و معنادار تبدیل میشوند. سپس این توکنها به جاسازیهایی (Embeddings) تبدیل میشوند که نمایشهای عددی از زمینه و معنی کلمات هستند. مدل با استفاده از این نمایشهای عددی، احتمال وقوع هر کلمه در موقعیت بعدی را محاسبه میکند و بهترین گزینه را انتخاب مینماید.
برای افزایش دقت و کیفیت، مدلها بر روی حجم بسیار زیادی از دادههای متنی، شامل میلیاردها صفحه، آموزش میبینند. این حجم وسیع داده به مدل اجازه میدهد تا قواعد گرامری، معناشناسی و روابط مفهومی بین کلمات و جملات را بدون نیاز به کدنویسی مستقیم و به صورت خودنظارتی یاد بگیرد. پس از پایان آموزش، مدل قادر است با پیشبینی کلمات بعدی و با بهرهگیری از دانش و الگوهایی که آموخته، متونی تولید کند که منسجم، مرتبط و طبیعی به نظر میرسند.
علاوه بر آموزش اولیه، عملکرد مدلها با روشهایی مانند مهندسی سریع (Prompt Engineering)، تنظیم سریع (Fine-tuning) و یادگیری تقویتی با بازخورد انسانی (RLHF) بهبود مییابد. این روشها به کاهش تعصبات ناخواسته، جلوگیری از تولید سخنان نفرتانگیز و کاهش خطاهای واقعی یا «توهم» کمک میکنند، که اغلب به دلیل آموزش بر روی دادههای بدون ساختار و ناهمگن رخ میدهند. این فرآیندها برای اطمینان از آماده بودن مدلهای سطح سازمانی بسیار حیاتی هستند تا سازمانها در معرض مسئولیتهای ناخواسته قرار نگیرند و اعتبار آنها حفظ شود.
در نهایت، مدلهای زبانی بزرگ با ترکیب حجم دادههای گسترده، معماری مبدل پیشرفته، و تکنیکهای آموزش و تنظیم دقیق، قادر به تولید محتوای زبانی غنی و کارآمد در حوزههای مختلف مانند ترجمه، پاسخ به سوالات، خلاصهسازی متون و تولید محتوا هستند و بدین ترتیب به بخش حیاتی فناوریهای مدرن تبدیل شدهاند.
کاربردهای مدلهای زبانی بزرگ
مدلهای زبانی بزرگ (LLM) به دلیل توانمندیهای گستردهشان، کاربردهای عملی متعددی در حوزههای مختلف دارند که باعث تحول در شیوه انجام بسیاری از وظایف متنی و زبانی شدهاند.
–کپیرایتینگ
علاوه بر مدلهای معروفی مانند GPT-3، ChatGPT، Claude، Llama 2، Cohere Command و Jurassic، که توانایی تولید متن اصلی و خلاقانه را دارند، ابزارهایی مانند AI21 Wordspice قادرند تغییراتی در جملات موجود ایجاد کنند تا سبک، لحن و کیفیت نوشتار بهبود یابد. این مدلها به نویسندگان، بازاریابان و تولیدکنندگان محتوا کمک میکنند تا متونی جذابتر و مؤثرتر تولید کنند.
–پاسخگویی مبتنی بر دانش
یکی از کاربردهای کلیدی LLMها در پردازش زبان طبیعی دانشمحور (Knowledge-Intensive NLP) است که امکان پاسخدهی دقیق و هدفمند به سوالات تخصصی را از طریق دسترسی به بانکهای اطلاعاتی و بایگانیهای دیجیتال فراهم میکند. نمونهای از این کاربرد را میتوان در AI21 Studio playground مشاهده کرد که قادر است به سوالات دانش عمومی و تخصصی پاسخ دهد و به عنوان یک ابزار قدرتمند در دسترس کاربران قرار گیرد.
–طبقهبندی متن
با بهرهگیری از الگوریتمهای خوشهبندی و طبقهبندی، مدلهای زبانی بزرگ میتوانند متون را بر اساس معانی، موضوعات یا احساسات دستهبندی کنند. این قابلیت در تحلیل احساسات مشتریان، تشخیص روابط بین اسناد و تسهیل جستجوی اطلاعات در مجموعههای بزرگ متنی کاربرد فراوان دارد و سازمانها را در درک بهتر دادههای متنی یاری میکند.
–تولید کد
LLMها در زمینه تولید کد از دستورات زبان طبیعی نیز عملکرد چشمگیری دارند. نمونههایی مانند Amazon CodeWhisperer و OpenAI Codex (که در GitHub Copilot به کار گرفته شدهاند) قادرند کدهایی به زبانهای مختلف برنامهنویسی مانند پایتون، جاوااسکریپت، روبی و دیگر زبانها تولید کنند. کاربردهای این تکنولوژی شامل نوشتن کوئریهای SQL، تولید دستورات shell و حتی طراحی وبسایت است که فرآیند برنامهنویسی را سرعت میبخشد و خطاهای انسانی را کاهش میدهد.
–تولید متن
مشابه تولید کد، مدلهای زبانی بزرگ میتوانند جملات ناقص را تکمیل کرده، مستندات محصول را به صورت خودکار ایجاد کنند یا حتی متنهای خلاقانه مانند داستانهای کوتاه و محتواهای متنی متنوع بنویسند. به عنوان مثال، Alexa Create توانایی تولید داستانهای کودکانه دارد که نشاندهنده قدرت این مدلها در خلق محتوا به صورت طبیعی و متناسب با نیاز کاربران است.
در مجموع، مدلهای زبانی بزرگ با ترکیب دقت بالا و انعطافپذیری در تولید، پردازش و تحلیل متون، ابزارهایی کاربردی و قدرتمند برای طیف وسیعی از صنایع و حوزهها فراهم آوردهاند که از خلق محتوا تا تحلیل دادههای متنی و برنامهنویسی هوشمند را شامل میشود.
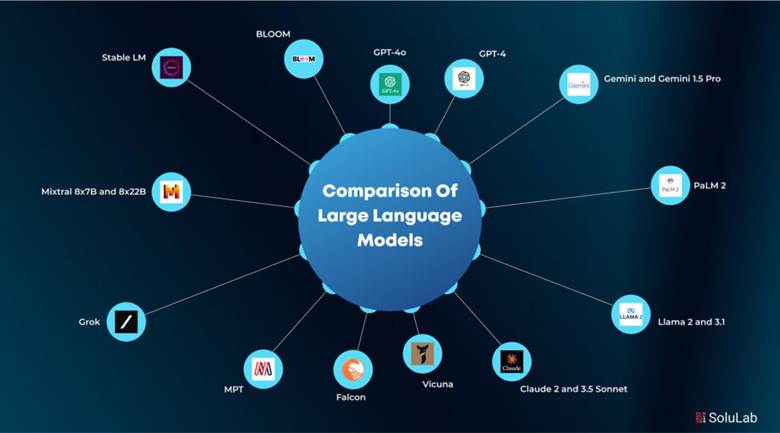
مقایسه مدلهای زبانی بزرگ LLM
| مدل | تعداد پارامتر | ویژگی شاخص |
| GPT-3 – OpenAI | ۱۷۵ میلیارد | تولید متن طبیعی و روان |
| Claude 2 | اعلام نشده | پردازش تا ۱۰۰ هزار توکن |
| Jurassic-1 – AI21 | ۱۷۸ میلیارد | دیکشنری ۲۵۰,۰۰۰ کلمهای |
| Command – Cohere | نامشخص | پشتیبانی از بیش از ۱۰۰ زبان |
| LightOn | نامشخص | قابلیتهای فراتر از GPT-3 (ادعایی ) |
سوال :تمامی این مدلها API دارند که به توسعهدهندگان امکان میدهد سرویسهای اختصاصی و پیشرفته بسازند.
LLM چه نوع AI است؟
جواب : LLM زیرمجموعه هوش مصنوعی مولد (Generative AI) و پردازش زبان طبیعی (NLP) است.
در آخر
در مجموع، مدلهای زبانی بزرگ با ترکیب دقت بالا و انعطافپذیری در تولید، پردازش و تحلیل متون، ابزارهایی کاربردی و قدرتمند برای طیف وسیعی از صنایع و حوزهها فراهم آوردهاند که از خلق محتوا تا تحلیل داده را شامل میشود.