آینده مدلهای زبانی بزرگ (Large Language Models): از ChatGPT تا تحول محیط کار و نقش AWS در توسعه هوش مصنوعی مولد
به شما پیشنهاد میکنم که قبل از مطالعه این مقاله کاربرد و مزایا و معایب مدل زبانی بزرگ را مطالعه نمایید.
مقدمهای بر مدلهای زبانی بزرگ (LLM) و اهمیت آنها
در چند سال اخیر، مدلهای زبانی بزرگ یا Large Language Models (LLM) مانند ChatGPT، Claude 2 و Llama 2، به عنوان پیشرفتهترین دستاوردهای هوش مصنوعی مطرح شدهاند که توانایی پاسخ به سوالات پیچیده و تولید متنی طبیعی و روان را دارند. این مدلها با پردازش حجم عظیمی از دادههای متنی، توانستهاند به تدریج به عملکردی نزدیک به زبان و تفکر انسان دست یابند. موفقیت چشمگیر این فناوری، توجه گستردهای را به سمت توسعه هوش مصنوعی مولد و مدلهای رباتیک که مغز انسان را تقلید میکنند، جلب کرده است. با رشد روزافزون تواناییهای LLMها، انتظار میرود که این تکنولوژی در آینده نقش کلیدی در صنایع مختلف، از جمله آموزش، پژوهش، تولید محتوا و حتی خدمات مشتری ایفا کند.
در اینجا چند نکته در مورد آینده LLMها آورده شده است:
–افزایش قابلیتها
هرچند که این فناوریها چشمگیر هستند، اما سطح فعلی فناوری بینقص نیست و LLMها نیز مصون از خطا نیستند. با این حال، نسخههای جدیدتر، دقت و قابلیتهای بیشتری خواهند داشت، زیرا توسعهدهندگان یاد میگیرند که چگونه عملکرد خود را بهبود بخشند و در عین حال تعصب را کاهش داده و پاسخهای نادرست را حذف کنند.
–آموزش سمعی و بصری
در حالی که توسعهدهندگان اکثر LLMها را با استفاده از متن آموزش میدهند، برخی نیز آموزش مدلها را با استفاده از ورودی ویدیو و صدا آغاز کردهاند. این شکل از آموزش باید منجر به توسعه سریعتر مدل شود و امکانات جدیدی را در زمینه استفاده از LLMها برای وسایل نقلیه خودران ایجاد کند.
–تحول در محیط کار
LLM ها یک عاملی هستند که محیط کار را تغییر خواهند داد. این مدلها احتمالاً وظایف یکنواخت و تکراری را به همان روشی که رباتها برای وظایف تولیدی تکراری انجام دادند، کاهش خواهند داد. از جمله این احتمالات میتوان به وظایف دفتری تکراری، چتباتهای خدمات مشتری و کپیرایتینگ خودکار ساده اشاره کرد.
–هوش مصنوعی مکالمهای
بدون شک LLMها عملکرد دستیارهای مجازی خودکار مانند الکسا، دستیار گوگل و سیری را بهبود خواهند بخشید. آنها بهتر میتوانند قصد کاربر را تفسیر کرده و به دستورات پیچیده پاسخ دهند.
سوال : آیا LLM واقعاً هوش مصنوعی است؟
پاسخ : بله، LLM یک شاخه از AI است.
: AI شامل همه سیستمهای هوشمند (بینایی ماشین، رباتیک، گفتار و...)
: LLM فقط روی زبان تمرکز دارد.
اما LLM آگاه یا دارای شعور نیست؛ فقط یک سیستم آماری پیچیده است که الگوهای زبانی را تقلید میکند.
چگونه AWS میتواند به LLM ها کمک کند؟
AWS مدلهای زبانی بزرگ (LLM) بخشی از هوش مصنوعی مولد هستند که میتوانند متون را در مقیاس وسیع پردازش، تحلیل و تولید کنند. برای کار با این مدلها معمولاً به زیرساختی نیاز است که توان پردازشی بالا، ذخیرهسازی بزرگ و ابزارهای مناسب توسعه را فراهم کند.
AWS یکی از ارائهدهندگان زیرساخت و خدمات ابری است که مجموعهای از ابزارها برای کار با LLMها در اختیار کاربران قرار میدهد. این خدمات شامل دو بخش اصلی هستند:
زیرساخت ابری مقیاسپذیر
AWS امکان استفاده از سرورها و منابع محاسباتی قدرتمند را فراهم میکند که میتوانند با توجه به نیاز پروژه افزایش یا کاهش پیدا کنند. این ویژگی برای آموزش مدلهای بزرگ یا اجرای آنها در مقیاس بالا ضروری است.سرویسهای هوش مصنوعی و یادگیری ماشینی
–Amazon Bedrock: ابزاری برای دسترسی به مدلهای زبانی مختلف بدون نیاز به ساخت یا مدیریت مستقیم زیرساخت.
–Amazon SageMaker JumpStart: بستری برای استفاده از مدلهای آماده و الگوریتمهای یادگیری ماشینی که میتوان آنها را بر اساس دادههای پروژه شخصیسازی کرد.
کاربردها :
با استفاده از این ابزارها میتوان پروژههای متنوعی را در حوزه پردازش زبان طبیعی، ترجمه، خلاصهسازی متن و تولید خودکار محتوا پیادهسازی کرد.
تولید شده توسط هوش مصنوعی:
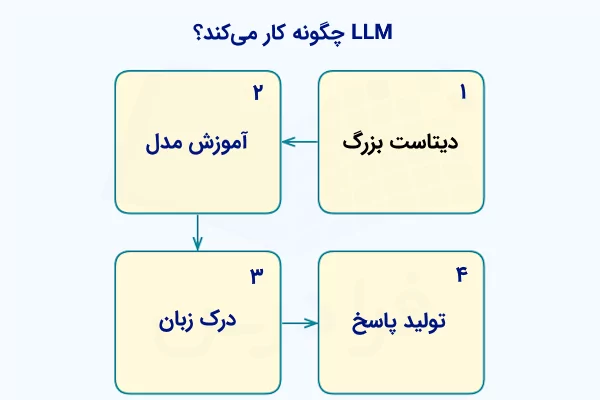
مدلهای زبانی با تخمین احتمال وقوع یک توکن یا دنبالهای از توکنها در یک دنباله طولانیتر، متن را پیشبینی و تولید میکنند که برای کارهایی مانند تولید متن و ترجمه مفید است.
مدلهای زبانی بزرگ (LLM) مدلهای زبانی پیشرفتهای با پارامترها و مجموعه دادههای گسترده هستند که آنها را قادر میسازد توالیهای متنی طولانیتر را پردازش کرده و وظایف پیچیدهای مانند خلاصهسازی و پاسخ به سوالات را انجام دهند.
شبکه مولد یک معماری کلیدی در LLMها هستند که از مکانیسمهای توجه برای تمرکز روی بخشهای ورودی مهم و افزایش کارایی پردازش استفاده میکنند.
LLMها کاربردهای مختلفی از جمله تولید متن، ترجمه، تحلیل احساسات و تولید کد دارند، اما ملاحظاتی مانند هزینه، سوگیری و پیامدهای اخلاقی را نیز در بر میگیرند.
مدلهای رایج یادگیری در LLMها
مدلهای زبانی بزرگ (LLM) برای ارائه بهترین عملکرد، از رویکردهای مختلف یادگیری استفاده میکنند که هر کدام برای سناریوهای خاصی طراحی شدهاند. سه مدل یادگیری اصلی که در این حوزه رایج هستند عبارتند از:
یادگیری بدون آموزش (Zero-shot): مدلها بدون آموزش خاص، قادر به انجام وظایف متنوع با استفاده از دستورالعملهای متنی هستند
یادگیری چند نمونهای (Few-shot): ارائه چند نمونه نمونه آموزشی باعث بهبود قابل توجه دقت مدل در حوزههای خاص میشود.
تنظیم دقیق (Fine-tuning): با آموزش مجدد مدل روی دادههای تخصصی، دقت و عملکرد در کاربردهای ویژه بهینه میشود.
اخبار و تحولات اخیر
–OpenAI در حال آانتشار GPT-5 است که با معماری پیشرفتهتر، دقت بالاتر و تواناییهای بیشتر در زمینه کدنویسی و استدلال، جایگاه جدیدی در بازار هدف قرار داده است.
–ChatGPT به رکورد بیش از ۷۰۰ میلیون کاربر فعال هفتگی رسیده و سهم بزرگی از بازار ابزارهای هوش مصنوعی را در اختیار دارد.
–تحقیقات UNESCO و UCL نشان داده که با بهینهسازیهای کوچک میتوان مصرف انرژی LLMها را تا ۹۰٪ کاهش داد، بدون افت محسوس در عملکرد.
–تمرکز بر توسعه مدلهای کوچکتر و کارآمدتر (SLM) بهعنوان راهکاری پایدار در حال افزایش است.
–گزارش بینالمللی ایمنی هوش مصنوعی هشدار داده که پیشرفت بدون کنترل این فناوری میتواند پیامدهای اجتماعی و امنیتی به همراه داشته باشد و نیاز به تنظیمگری هوشمندانه وجود دارد.
در اخر
آینده مدلهای زبانی بزرگ (LLM) با ترکیبی از پیشرفتهای فنی، افزایش تنوع کاربردها و بهینهسازی مصرف منابع شکل میگیرد. با حرکت به سمت مدلهای چندرسانهای، توانمند در استدلال و همزمان پایدارتر و ایمنتر، LLMها نقش برجستهای در تحول صنایع مختلف، آموزش، پژوهش و زندگی روزمره خواهند داشت. همچنین، استفاده از خدمات ابری مانند AWS و ابزارهای مدیریتی، توسعه و پیادهسازی این فناوریها را برای سازمانها آسانتر و مقرونبهصرفهتر میکند. برای آشنایی بیشتر با دنیای مدلهای زبانی، مطالعه مقاله تخصصی ما در این زمینه توصیه میشود.